Como especialistas suizos en automatización de pruebas, gestión de datos de prueba e inteligencia artificial, nos apasiona explorar las últimas tecnologías y posibilidades. Una de estas nuevas posibilidades es la generación de datos de prueba sintéticos mediante la inteligencia artificial generativa (IA generativa). En Infometis, dedicamos gran parte de nuestro tiempo a las tendencias y tecnologías de vanguardia, por lo que analizamos este tema en detalle durante un hackatón conjunto.

La importancia de los datos de prueba sintéticos para la gestión moderna de datos de prueba
Desafíos en la gestión de datos de prueba
Cuando hablamos de pruebas, ya sean automatizadas o manuales, inevitablemente debemos hablar de la gestión de datos de prueba. Unas pruebas eficientes solo son posibles con los datos de prueba adecuados. Por lo tanto, la rápida disponibilidad de datos de prueba suficientes es un factor clave para el éxito de todas las actividades de prueba.
Especialmente en entornos empresariales complejos, proporcionar datos de prueba o encontrar conjuntos de datos adecuados supone un enorme desafío para las empresas y, a menudo, una jungla difícil de penetrar llena de dependencias, excepciones y problemas heredados.
Al atravesar esta jungla, uno suele encontrarse con trampas:
- No se dispone de un conjunto específico de datos para probar una nueva función o para realizar pruebas de regresión
- Datos insuficientes para las pruebas de carga y rendimiento
- Datos consumidos después de las ejecuciones de prueba
- Falta de integración en el pipeline de CI/CD
- Requisitos de protección de datos para modelos LLM que necesitan preservar las estructuras de datos
- Esto se traduce en un elevado coste total de propiedad.
Soluciones tradicionales y sus limitaciones
Las soluciones actuales a estos desafíos incluyen:
- Clonación de datos de producción a entornos de prueba (🫣)
- Transferir datos de producción, enmascarados, seudonimizados o anonimizados, a entornos de prueba
Estos enfoques conllevan los siguientes riesgos y desventajas:
Riesgos para la protección de datos y ciberdelincuencia: Ante la creciente regulación en materia de protección de datos, la limitación de la finalidad y las restricciones de acceso, especialmente para la información de identificación personal (IIP), son motivo de gran preocupación. El uso de datos de producción para fines de prueba, incluso enmascarados o anonimizados, supone un riesgo significativo para la protección de datos y aumenta la superficie de ataque para los ciberdelincuentes.
Falta de fiabilidad de los datos: La ejecución eficiente de las pruebas de regresión, tanto funcionales como no funcionales, depende de datos de prueba fiables. Los datos procedentes de sistemas de producción pueden contener configuraciones no deseadas que afectan negativamente a los resultados de las pruebas. El análisis de errores resultante puede desviarse del objetivo real de la prueba. Además, un mayor grado de anonimización reduce su idoneidad para campañas de pruebas más amplias.
Estructura: Para identificar casos extremos y simular escenarios realistas durante las pruebas de carga y rendimiento, es fundamental que la estructura de los datos, incluyendo series temporales y transacciones, refleje fielmente los datos de producción. Anonimizar los datos o generar datos simulados altera la estructura o impide capturar toda su complejidad. Este inconveniente también resulta crítico al entrenar modelos de IA propios.
Alto esfuerzo manual: El esfuerzo necesario para proporcionar conjuntos de datos anonimizados suele ser muy elevado. Esto consume recursos y reduce la disponibilidad de los sistemas de prueba. Además, si los datos se proporcionan de forma irregular, los entornos de prueba quedan obsoletos rápidamente y la calidad de los datos se deteriora.
Más que anonimización: datos de prueba sintéticos
Los datos de prueba sintéticos, la simulación artificial de datos del mundo real, ofrecen la importante ventaja de desvincularlos por completo de los datos de producción, preservando al mismo tiempo las complejas relaciones entre ellos. Esto contrarresta las desventajas de los datos de prueba tradicionales en cuanto a protección de datos y representación estructural.
Herramientas como iSynth ayudan a definir y mantener datos de prueba sintéticos como código y a implementarlos de forma consistente en entornos de prueba, independientemente de la variación y la cantidad
Plataformas como Tonic.ai o k2view ofrecen muchas herramientas excelentes para identificar, transformar y generar automáticamente datos sintéticos a partir de información de identificación personal (PII) en fuentes de datos de producción.
Los marcos de automatización como Tosca, TAMI o GenRocket se benefician de la capacidad de una organización para crear y mantener pruebas de regresión automatizadas, incluidas las constelaciones de datos necesarias.
Sin embargo, lo que queda es el esfuerzo necesario para analizar y mantener la estructura de los datos reales, derivar las reglas y los algoritmos, e implementarlos.
El avance de la inteligencia artificial , y en particular de la IA generativa, podría ayudarnos precisamente en este ámbito.
¿La solución? Utilizar inteligencia artificial para generar datos de prueba sintéticos
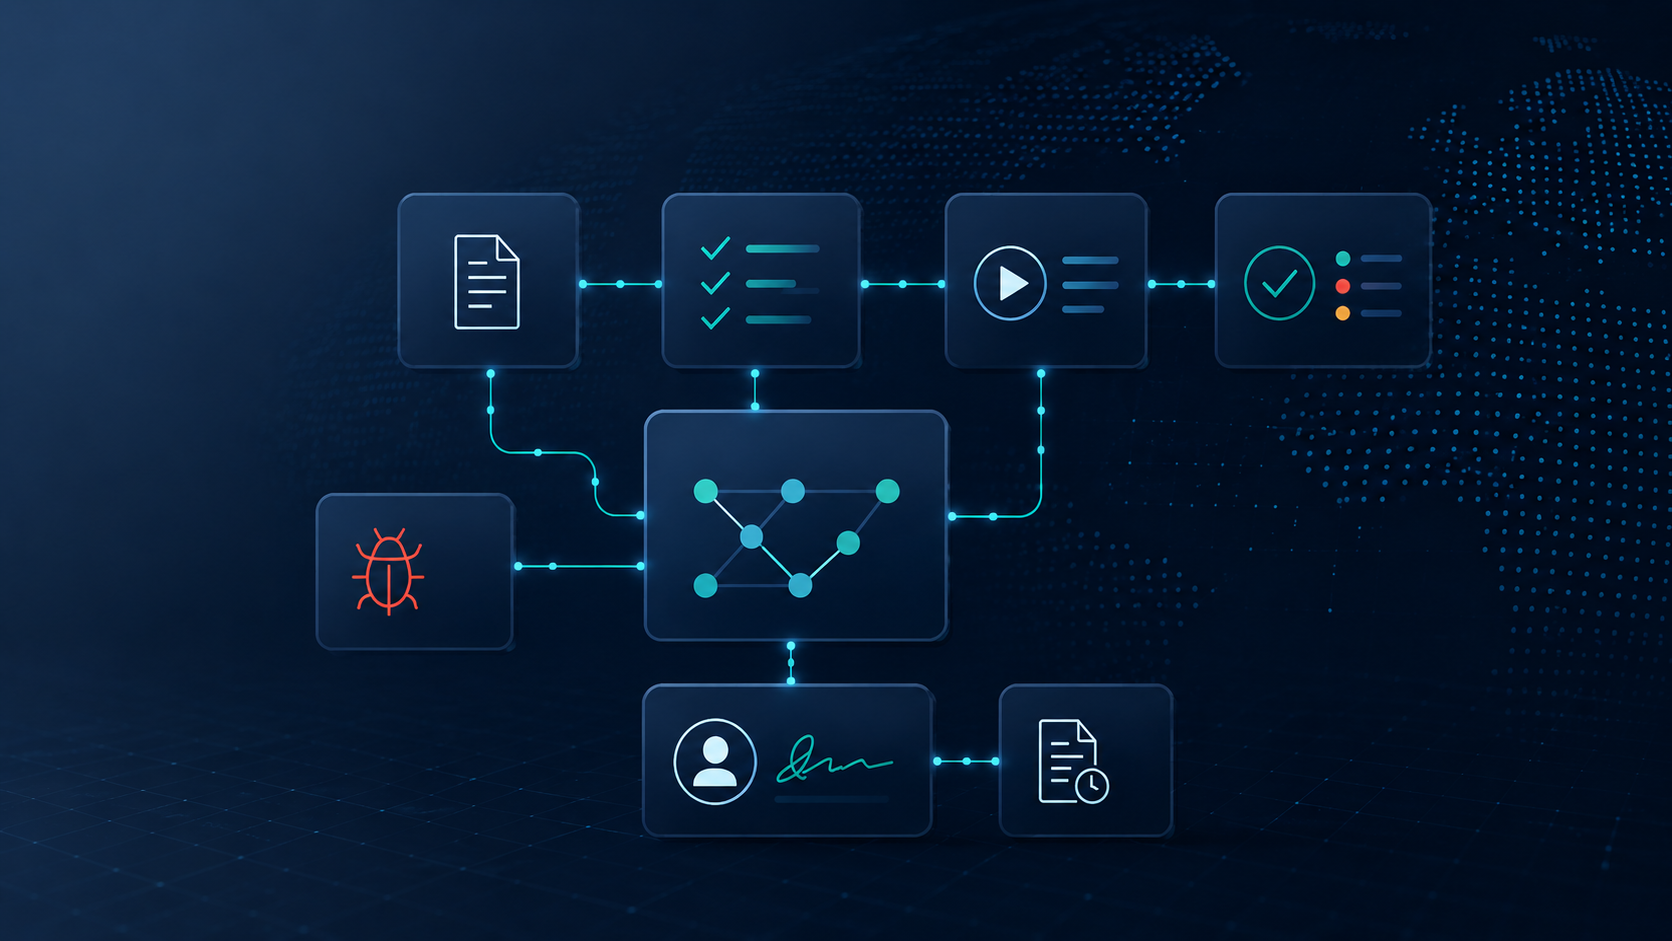
Las herramientas y plataformas de IA para generar datos de prueba sintéticos utilizan las capacidades de la IA generativa para aprender la estructura y las relaciones de los datos de producción y generar datos de prueba sintéticos con el modelo resultante.

Esto delega la laboriosa tarea de analizar y documentar estructuras y dependencias a la IA, capturándolas en un modelo de IA específico para los datos. Mediante este modelo completamente anónimo, la IA puede, en un segundo paso, generar la cantidad deseada de datos sintéticos bajo demanda dentro del entorno deseado.
Análisis de mercado: Herramientas para datos de prueba sintéticos con IA generativa
En Infometis, monitorizamos continuamente el mercado, analizamos las últimas novedades, participamos activamente en tecnologías innovadoras y líderes del sector, y mantenemos un contacto estrecho con los fabricantes. Esto nos permite ofrecer siempre a nuestros clientes las mejores soluciones.
Para generar datos de prueba sintéticos con IA, analizamos detenidamente las siguientes dos plataformas. Están especializadas específicamente en la generación de datos de prueba sintéticos mediante IA generativa.
El objetivo era comprender nuestra situación actual y hacia dónde podría conducirnos.
Principalmente IA

En el corazón de Mostly AI se encuentran los generadores. Estos pueden alimentarse con datos mediante conectores o carga de archivos. En el siguiente paso, se puede entrenar un modelo de IA basado en datos, que a su vez constituye la base para generar datos sintéticos.
Mediante un asistente (GPT), puede interactuar con un generador y, por ejemplo, analizar tablas de datos con mayor detalle. También es posible generar datos de prueba bajo demanda o analizar un archivo de datos independientemente de los generadores mediante una solicitud
La IA destaca por su fácil acceso. Con tan solo unos clics, se puede generar un modelo de IA y datos sintéticos a partir de un archivo CSV. Además, los usuarios pueden obtener información detallada sobre las estadísticas de los datos si lo desean.

Además, Mostly ofrece una interfaz de línea de comandos (CLI) en Python, lo que permite su integración en flujos de trabajo de CI/CD y otras automatizaciones. Esto posibilita, por ejemplo, la generación y el suministro de datos bajo demanda para pruebas automatizadas. Todos los generadores configurados en la nube también pueden representarse como código Python.

Gretel

Gretel está organizado en proyectos. Dentro de un proyecto, puedo entrenar varios modelos con diferentes datos. Para ello, Gretel proporciona plantillas para distintos casos de uso.

El Navegador me permite generar datos de prueba bajo demanda mediante una solicitud , de forma similar al asistente de Mostly AI. También puedo añadir columnas a tablas existentes según ciertas reglas
Con Gretel, es muy rápido obtener resultados iniciales. Los planos permiten aplicar diferentes casos de uso a los datos de origen. Puedo entrenar un modelo que genere datos de prueba sintéticos o uno que clasifique mis datos según la información de identificación personal (PII).
Para cada modelo, Gretel genera un informe de calidad con abundante información. Gretel también ofrece una interfaz de línea de comandos (CLI) en Python. Más precisamente, dos: un SDK de Gretel de bajo nivel y otro de alto nivel.
Vale la pena mencionar la función de flujo de trabajo de Gretel. Permite configurar automatizaciones personalizadas, como la creación de 500 registros de prueba todos los viernes a las 8:00 a. m.

Despliegue e integración
Probamos ambas herramientas en la nube utilizando los créditos disponibles en el modelo gratuito. En la mayoría de los escenarios empresariales, es fundamental que los datos de producción permanezcan dentro del contexto de la empresa.
Por lo tanto, ambas herramientas ofrecen la opción de implementarlas en un clúster de Kubernetes bajo el control de la empresa. Esto permite entrenar el modelo de IA con datos de producción dentro del contexto propio de la empresa.
⚠️ El modelo de IA entrenado en ambas herramientas ya no tiene ninguna conexión con los datos originales. Por lo tanto, puede utilizarse para generar datos sintéticos en la nube.
Gretel aún se limita a los tres principales proveedores de servicios en la nube, mientras que Mostly AI también ofrece un gráfico de Helm para su implementación en un entorno autohospedado.

Posibles usos:
- Principalmente IA: Ideal para empresas que prefieren el autoalojamiento para mantener los datos confidenciales localmente.
- Gretel.ai: Eficaz para la entrega automatizada de datos basada en la nube en industrias reguladas.
Próximos pasos
Los datos de prueba siempre han sido uno de los principales desafíos para realizar pruebas eficientes. El aumento de los requisitos de protección de datos, el creciente cibercrimen y la creciente regulación del sector incrementan aún más la complejidad.
La gestión de datos de prueba, y en particular la provisión de datos de prueba sintéticos, adquirirá aún mayor importancia en un futuro próximo de la que ya tiene hoy. Además, la tecnología avanza rápidamente.
Las crecientes capacidades de las soluciones de IA para generar datos sintéticos llegan en el momento oportuno. Sin embargo, esto no resuelve de la noche a la mañana el gran desafío de proporcionar datos de prueba adecuados. En nuestra opinión, desarrollar experiencia en IA y evaluar el progreso tecnológico son fundamentales para desarrollar estrategias sostenibles y seguras de suministro de datos de prueba.
Como su socio suizo en materia de calidad y automatización de software, estamos siempre al tanto de las últimas tendencias del mercado e incorporamos continuamente nuestros hallazgos a nuestros servicios de consultoría y soporte.
¿Desea actualizar la gestión de sus datos de prueba? Nos complacerá tener una primera conversación al respecto.